
Pourquoi une machine puissante pour l’IA ?
ChatGPT, Llama, Mistral, Stable Diffusion, ComfyUI… Faire tourner l’intelligence artificielle chez vous ou dans votre entreprise demande un matériel très particulier. Un PC classique, même récent, se heurte vite à trois murs : la mémoire, la bande passante et le nombre de cœurs. Ce guide vous explique simplement, chiffres et graphiques à l’appui, pourquoi une workstation IA (Threadripper, Xeon, cartes NVIDIA RTX) change complètement la donne – et pourquoi c’est un investissement rentable.
Ce que fait vraiment une IA dans votre PC
Une IA générative (un « LLM » comme Llama ou Mistral, ou un générateur d’images) est un gigantesque fichier de milliards de nombres – les paramètres. Pour produire chaque mot ou chaque image, la machine doit relire tout ce fichier et faire des milliards de multiplications en parallèle. Imaginez une bibliothèque de 70 milliards de pages qu’il faut parcourir entièrement pour écrire chaque mot : la taille des étagères (mémoire), la vitesse des allées (bande passante) et le nombre de bibliothécaires (cœurs) font toute la différence.
Carte graphique (GPU)
Des milliers de cœurs CUDA et Tensor qui calculent en parallèle. C’est le moteur n°1 de l’IA, et la raison pour laquelle nous montons des cartes NVIDIA : tout l’écosystème IA (CUDA, PyTorch, Ollama, ComfyUI) est optimisé pour elles.
Mémoire vidéo (VRAM)
Le modèle doit tenir entièrement dans la VRAM pour être rapide. 16 Go suffisent pour un petit modèle, il en faut 48 à 96 Go (voire plus) pour les modèles « intelligents » de 70 milliards de paramètres et plus.
Bande passante mémoire
La vitesse à laquelle les données circulent entre la mémoire et les unités de calcul. C’est elle qui fixe le nombre de mots générés par seconde. Elle double ou quadruple avec les plateformes Threadripper et Xeon.
Capacité RAM
Quand le modèle déborde de la VRAM, il se loge dans la RAM système. 256 Go, 512 Go ou plus permettent de charger les très gros modèles, des bases de données vectorielles (RAG) et de gros jeux de données.
Processeur (cœurs CPU)
Il prépare les données, découpe les textes (tokenisation), alimente les GPU, compile, fait tourner les conteneurs et les agents. Plus de cœurs = moins d’attente et plusieurs tâches IA en même temps.
Lignes PCIe & stockage NVMe
Les « autoroutes » qui relient GPU et SSD au processeur. Indispensables pour brancher 2, 3 ou 4 cartes graphiques à pleine vitesse et charger des modèles de plusieurs centaines de Go en quelques secondes.
Règle n°1 : le modèle doit tenir en mémoire
La taille d’un modèle se compte en milliards de paramètres (« B »). En version compressée (quantification 4 bits, le format le plus utilisé en local), comptez environ 0,6 Go de mémoire par milliard de paramètres, plus un peu de place pour le contexte (la « mémoire de conversation »).
Un petit modèle de 8B tient dans n’importe quelle carte graphique récente. Mais les modèles qui rivalisent vraiment avec les IA en ligne – 70B, 120B, 405B – demandent de 40 à plus de 240 Go. Si le modèle ne tient pas, il est soit impossible à lancer, soit découpé entre GPU et RAM… et devient alors 10 à 50 fois plus lent.
Mémoire nécessaire (quantification 4 bits)
Et dans quelle configuration le modèle tient entièrement
La bande passante fait la vitesse de réponse
Pour écrire chaque mot (un « token »), l’IA relit l’intégralité du modèle en mémoire. La vitesse de génération dépend donc directement de la bande passante mémoire :
Un PC grand public en DDR5 2 canaux plafonne autour de 77 à 90 Go/s. Un Threadripper (4 canaux) monte à 205 Go/s, un Xeon W-3400 (8 canaux) à 307 Go/s et un Threadripper PRO (8 canaux DDR5-6400) à 410 Go/s. Une carte RTX 5090 ou RTX PRO 6000 atteint 1 792 Go/s – d’où l’intérêt d’une VRAM abondante.
Pour un confort de lecture, on vise au moins 10 tokens/s (un humain lit environ 5 à 8 mots par seconde). En dessous de 3 tokens/s, l’IA devient pénible à utiliser au quotidien.
Simulateur de vitesse
Choisissez un modèle : estimation théorique des tokens/s selon la plateforme
Estimation : bande passante × 70 % d’efficacité ÷ taille du modèle en 4 bits. Les résultats réels varient selon le logiciel (llama.cpp, vLLM…), le contexte et les réglages.
Processeur simple vs Threadripper et Xeon
Un Core i5 ou un Ryzen grand public est parfait pour la bureautique et le jeu. Mais pour l’IA, il manque de cœurs, de canaux mémoire, de lignes PCIe et de capacité RAM. Comparez les 4 critères qui comptent :
Multi-cœur : score PassMark CPU Mark (moyenne des résultats publiés, valeur ≈ pour le Core i5). Bande passante : maximum théorique (canaux × fréquence DDR5). Données constructeurs AMD et Intel. Détail complet sur notre page Benchmarks processeurs IA.
| Critère | PC bureautique / gaming | Threadripper (HEDT) | Xeon W / Threadripper PRO |
|---|---|---|---|
| Cœurs / threads | 6 à 24 cœurs | 24 à 64 cœurs / 128 threads | 12 à 96 cœurs / 192 threads |
| Canaux mémoire | 2 canaux DDR5 | 4 canaux DDR5 | 8 canaux DDR5 |
| RAM maximale | 192 à 256 Go | jusqu’à 1 To | 2 To (TR PRO) à 4 To (Xeon W-3400) |
| Mémoire ECC | Non (ou limitée) | Oui (RDIMM ECC) | Oui (RDIMM ECC) |
| Lignes PCIe CPU | 20 à 24 | jusqu’à 88 | 64 à 128 (PCIe 5.0) |
| GPU à pleine vitesse (x16) | 1 | 2 à 3 | jusqu’à 4 et plus |
| Instructions IA | AVX2 / AVX-512 (AMD) | AVX-512 | AVX-512, AMX (Xeon) |
| Usage idéal | Petits modèles, découverte | IA locale avancée, création 3D/vidéo | Entraînement, multi-GPU, serveur IA d’équipe |
Concrètement : combien de temps gagné ?
Préparer un jeu de données, indexer des milliers de documents pour un assistant interne (RAG), compiler, encoder des vidéos, faire tourner plusieurs agents IA : ces tâches exploitent tous les cœurs du processeur.
Exemple : une tâche qui prend 1 heure sur un PC bureautique Core i5 ne prend plus qu’environ 9 minutes sur un Threadripper PRO 9995WX. Sur une année, pour un professionnel qui lance ce type de traitements tous les jours, ce sont des centaines d’heures rendues à votre activité.
Durée d’une tâche multi-thread de 60 min
Plus la barre est courte, mieux c’est
Estimation proportionnelle au score multi-cœur PassMark, pour une tâche parfaitement parallélisable.
Plusieurs GPU ? Il faut des lignes PCIe
Une carte graphique a besoin de 16 lignes PCIe pour fonctionner à pleine vitesse. Avec 20 à 24 lignes, un PC grand public ne peut alimenter correctement qu’un seul GPU. Pour cumuler la VRAM de 2, 3 ou 4 cartes (et charger des modèles de 200 à 400 Go en VRAM), seule une plateforme Threadripper, Threadripper PRO ou Xeon W le permet.
PC grand public
1 GPU à pleine vitesse, 2 en x8 au mieux.
Xeon W-2400
2 GPU à pleine vitesse + stockage rapide.
Threadripper TRX50
Jusqu’à 3 GPU en x16 + NVMe.
TR PRO WRX90 / Xeon W-3400
4 GPU en x16 + NVMe, réseau 10/25 GbE.
Machine locale ou cloud : le calcul
Louer un GPU dans le cloud semble économique… jusqu’à ce qu’on l’utilise tous les jours. Une workstation IA locale se rembourse généralement en 1 à 3 ans, puis ne coûte plus que son électricité. Et vos données ne quittent jamais vos locaux.
Électricité comptée pour la machine locale : 0,7 kW à 0,25 €/kWh. Simulation indicative, hors avantages fiscaux (amortissement du matériel).
Confidentialité & RGPD
Contrats, dossiers clients, données médicales ou code source restent sur votre machine. Aucune donnée envoyée à un service tiers.
Aucune limite
Pas d’abonnement par utilisateur, pas de quota de requêtes, pas de file d’attente. Toute votre équipe peut l’utiliser en réseau.
Liberté totale
Choisissez vos modèles open source, fine-tunez-les sur vos données, et faites évoluer la machine (GPU, RAM) au fil de vos besoins.
Quelle workstation pour quel usage ?
Assemblées et testées dans notre atelier de Labège (Toulouse), nos workstations IA sont livrées prêtes à l’emploi : Windows ou Ubuntu, pilotes NVIDIA, CUDA, Ollama ou LM Studio installés sur demande.
Forge Rapid X
Ryzen 9 9950X + RTX 16 Go. Ollama, LM Studio, ComfyUI au quotidien, modèles jusqu’à 14B.
Voir →
Forge IA Platinium
1 ou 2 RTX professionnelles jusqu’à 48 Go, jusqu’à 256 Go de DDR5. Modèles 32B à 70B.
Voir →
Forge Gaïa
Plateforme W790, DDR5 ECC, instructions AMX. Fiabilité station de travail pour l’entreprise.
Voir →
Forge Venom
Threadripper TRX50, alimentation 2500 W, multi-GPU. L’IA locale sans compromis.
Voir →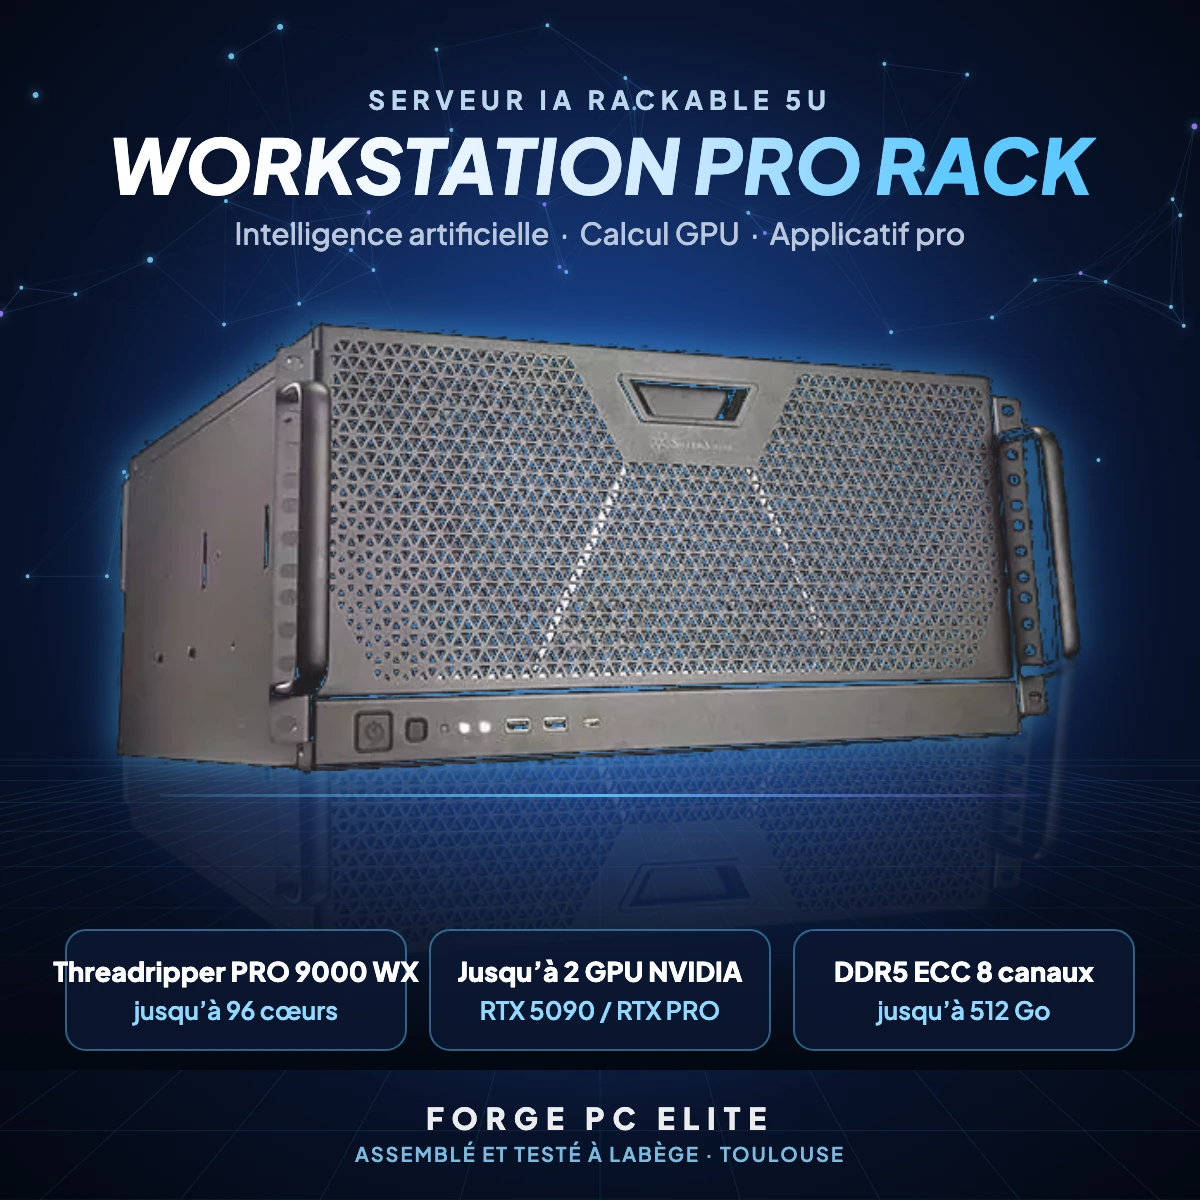
Workstation Pro Rack
Threadripper PRO jusqu’à 96 cœurs, 8 canaux ECC, RTX PRO. Le serveur IA de toute l’équipe.
Voir →Questions fréquentes
Quelle configuration minimum pour faire tourner une IA en local ?
Pourquoi un Threadripper ou un Xeon plutôt qu’un Ryzen 9 ou un Core i9 ?
Le processeur compte-t-il vraiment si c’est le GPU qui calcule ?
Combien de VRAM faut-il pour Llama 70B ?
Une workstation IA est-elle rentable par rapport au cloud ?
Pourquoi uniquement des cartes NVIDIA ?
Livrez-vous la machine prête à l’emploi ?
Votre IA mérite la bonne machine
Décrivez-nous vos usages (modèles, nombre d’utilisateurs, budget) : nous vous proposons la configuration la plus juste, sans surdimensionner.